
OWASP Releases GenAI LLM Top 10 2026 for Building and Securing Modern AI Apps
2026/08/06 CyberSecurityNews —
Open Worldwide Application Security Project (OWASP) が正式にリリースしたのは、Top 10 for LLM Applications 2026 である。これは、現代の AI アプリケーションと自律型エージェント全体における深刻度の高い脆弱性を対象とする、基礎的なセキュリティ・ガイドである。今回のアップデート版は、急速に進化するエンタープライズ生成 AI 展開に対応する開発者/アーキテクト/最高情報セキュリティ責任者に向けて、コミュニティ主導の証拠に基づくベースラインを確立している。
OWASP によるアップデート・リリースは、カスタマー・サポート・ワークフロー/開発者ツール/生産性スイート/エージェント型ワークフローへと、ユーザー組織が LLM を積極的に組み込む中で登場した。
このガイドは、プロジェクト・リードの Steve Wilson と Rock Lambros が主導する設計思想を軸にするものだ。それは、”欺くことができない” LLM を構築するのではなく、モデルが侵害された場合の下流への影響を封じ込めるために、周囲のアプリケーション・アーキテクチャを強化すべきという考え方である。
OWASP GenAI LLM Top 10 2026
以前のリリースとは異なり、2026年版のフレームワークは、公開脆弱性データベースと AI 被害リポジトリから収集された、実際の AI 関連セキュリティ・インシデント 7,714 件の実証データセットに直接基づいている。そのうち 6,639 件には、分類に十分な詳細が含まれていた。
プロジェクト・チームは、実務者コミュニティからの意見に対して 75% を、インシデント・データに対して 25% を、ウェイトとして取り込んでいる。それにより、認識されている脅威の深刻度と、本番環境で実際に悪用されている状況との差異を調整している。
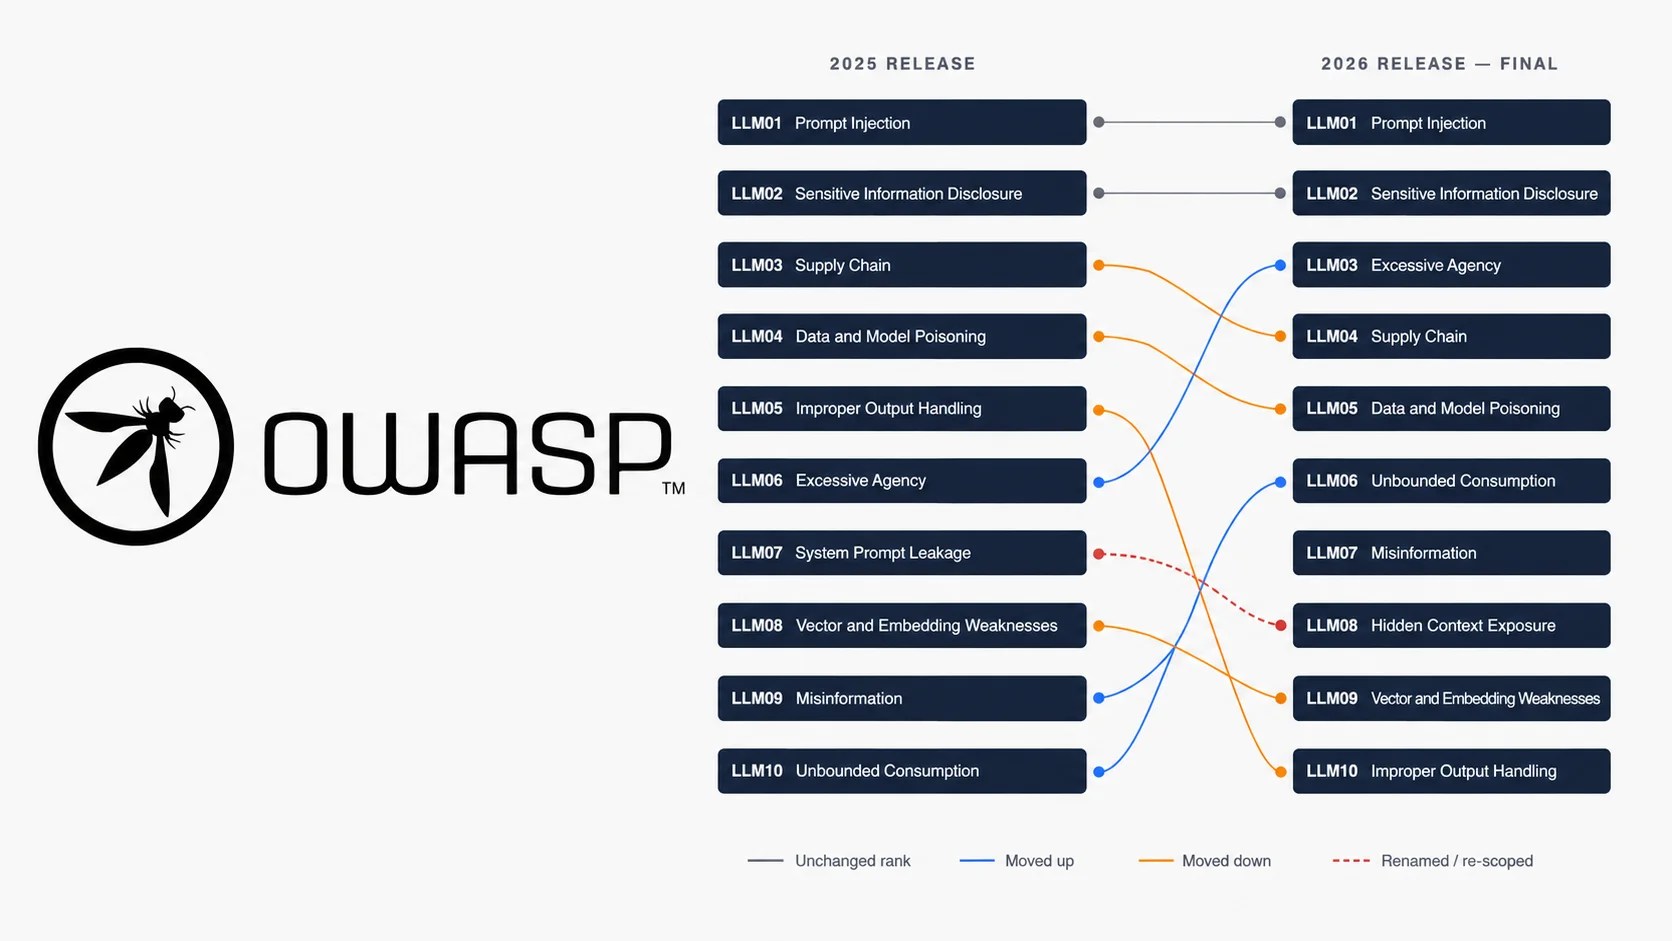
明確な公開エクスプロイトは依然として少ないが、Prompt Injection は LLM01 の位置を維持している。この継続性は、モデルが信頼されていないテキストを取り込む入口が、依然として防御を必要とするアクティブな攻撃対象領域であるという現実に起因している。
その一方で、Misinformation (LLM08) は優先度を上げている。不正確でありながら自信を持って生成された AI 出力が、自動化されたビジネス・ワークフローや未承認の API 呼び出しを発生させた場合に、広範な実世界の被害が発生していることが、インシデント記録により明らかにされている。
規制遵守を維持して運用リスクを緩和するために、ユーザー組織が包括的な AI セキュリティ・フレームワークを採用する中で、これらの構造的な変化を理解することは極めて重要である。
2026年版におけるランキングの調整は、現代のエンタープライズ AI アーキテクチャにおける技術的な複雑性の高まりを反映している。
- Excessive Agency (LLM03) :モデル出力が自律的にシェル・コマンドを実行し、外部 API を呼び出し、データベース・トランザクションを管理するエージェント型システムの周辺に、本番環境でのインシデントが集中したことで大幅に上昇した。
- Unbounded Consumption (LLM10):4 ランク上昇した。拡張思考モデル/マルチモーダル推論エンジン/共有コンピュート・クラスターを標的とする、新たな可用性リスクおよび金銭的な Denial-of-Service リスクを浮き彫りにしている。これらの環境を保護するには、アクティブな AI セキュリティ・プラットフォーム全体でリソース割り当てを管理する必要がある。
- Hidden Context Exposure (LLM09):System Prompt Leakage から範囲が拡大され、システム指示/RAG スキーマ/隠されたポリシー・ロジックなどの、ユーザーには見えないすべてのコンテキストが対象になった。これらの流出により、攻撃者の能力が拡大する。
- Improper Output Handling (LLM06):ランクを下げたが、この欠陥が解決されたわけではない。入力境界のプロンプト・インジェクションと、パイプライン横断のデータ開示が、現在のインシデントを支配しているためである。
| Vulnerability ID | Vulnerability Name | Primary Risk Vector & Impact |
| LLM01 | Prompt Injection | Direct/indirect jailbreaks, Unicode bypasses, and self-replicating lures |
| LLM02 | Sensitive Info Disclosure | Training data memorization, RAG chunk leakage, and side-channel timing |
| LLM03 | Excessive Agency | Autonomous tool abuse, shell command execution, and unchecked API calls |
| LLM04 | Data and Model Poisoning | Contaminated pre-training datasets, fine-tuning lures, and adapter compromise |
| LLM05 | Improper Supply Chain | Compromised base models, unsafe serialization formats, and rogue registries |
| LLM06 | Insecure Output Handling | Unsanitized code, SQL, or HTML generation leading to secondary XSS/RCE |
| LLM07 | Vector and Memory Flaws | RAG embedding manipulation, context poisoning, and cross-session bleed |
| LLM08 | Misinformation | Hallucinations driving flawed automated actions or legal/financial decisions |
| LLM09 | Hidden Context Exposure | Exfiltration of system prompts, policy logic, tool schemas, and guards |
| LLM10 | Unbounded Consumption | Cost spikes, token exhaustion, and resource starvation on shared clusters |
公式の OWASP GenAI LLM Top 10 2026 ドキュメントに詳述されているように、各項目で示されているのは、攻撃の構造/本番環境シナリオ/即時実装を目的とした階層型の緩和パターンである。
2026年版リリースの重要な特徴は、Appendix A にある。そこでは、すべての LLM Top 10 リスクが、確立されたエンタープライズ・セキュリティ標準へ直接対応付けられている。このマッピングは以下を対象としている。
- OWASP Standards:Top 10 for Agentic Applications (ASI) および GenAI Data Security 2026 (DSGAI)
- MITRE Frameworks:MITRE ATLAS/MITRE ATT&CK/MITRE CWE
- NIST & CSA Standards:NIST AI 600-1 (Generative AI Profile) /NIST AI RMF/CSA AI Controls Matrix
このフレームワークを横断する整合性により、このドキュメントはブリッジ・マニュアルへと変化する。それによりセキュリティ・チームは、独立したかたちで LLM リスクを管理するのではなく、既存の脅威モデルへ統合できる。
このレポートは、”コンポーネントとしての LLM” と “アクターとしての LLM” を扱う際の明確な区別も確立している。
モデルに対してツール/永続メモリ/実行権限が付与される場合に、チームに指示されるのは、Agentic Applications Top 10 と併せて LLM Top 10 を展開することだ。この制御が組み込まれることで、現代の SOC ワークフローにおいて、サイバー・セキュリティにおける AI のリスクと利点の両方を管理できるようになる。
OWASP が開発チームに対して助言するのは、2026年版 Top 10 を運用プレイブックとして扱うことだ。
- Least Agency の強制:AI エージェントに付与される能力を制限する。機密性が高く、取り消し不能な操作には、人間参加型の承認を必須にする。
- 検索前の認可:埋め込み生成の前に、ベクトル・データベースと RAG パイプラインに対する厳格なアクセス制御チェックを実装する。
- 入力と出力の検証:モデル・レスポンスを信頼されていないものとして扱い、生成された SQL/HTML/コードを実行エンジンへ渡す前に、厳格な出力検証を強制する。
- サプライチェーンの保護:サードパーティのモデル重み/ファインチューニング・データセット/オープンソース・ツールについて、シリアライズの脆弱性やデータ・ポイズニングの有無を監査する。
訳者後書:OWASP Top 10 for LLM Applications 2026 が、最新のセキュリティ動向やリスクに対応するかたちでアップデートされました。AI アプリケーションや自律型エージェントの導入が進む中で、プロンプト・インジェクションや不正確な出力による自動処理の誤作動など、予期せぬ挙動や情報流出のリスクが高まっています。このガイドラインは、モデルの侵害を前提とした防御構造やアクセス権限の最小化といった、設計指針を示すものです。システムを安全に利用するためにも、入力/出力の厳格な検証やサプライチェーンの安全確保を速やかに推進することが推奨されます。


You must be logged in to post a comment.